Garment Try-Off LoRA (MiniMax H3)
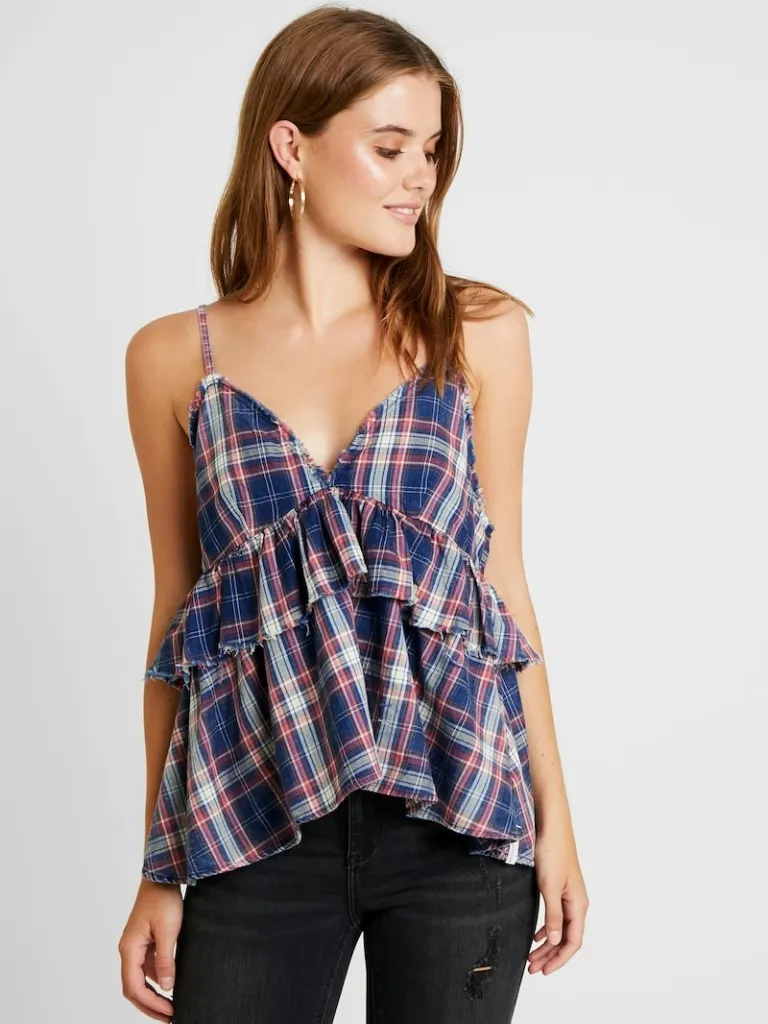
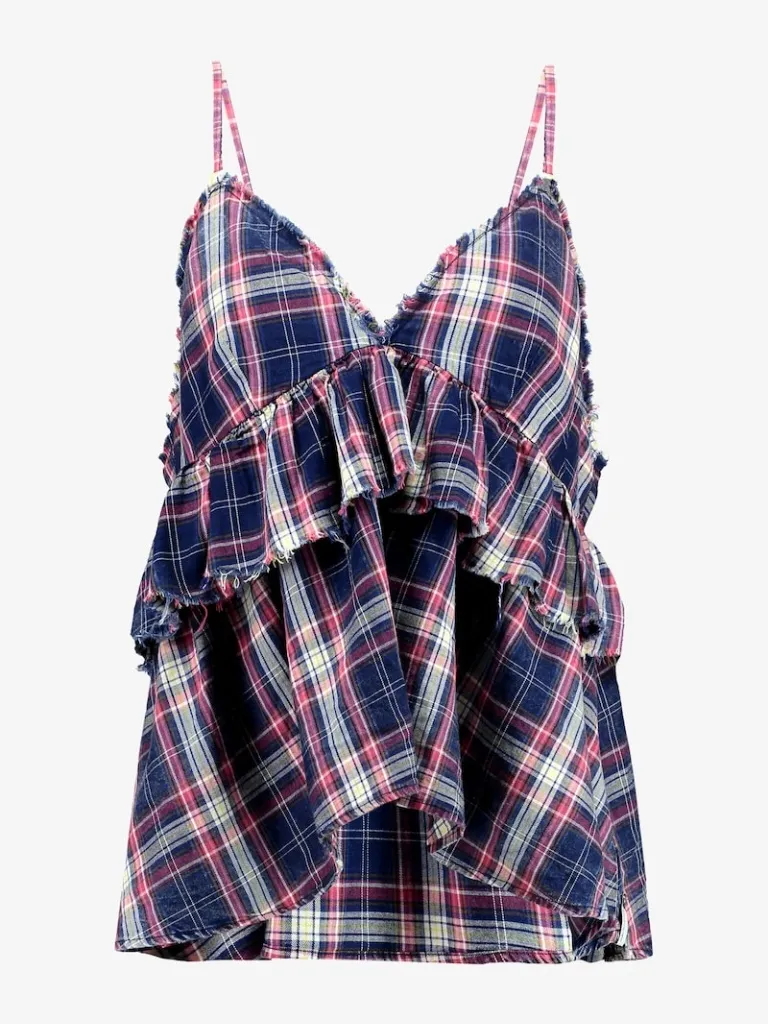
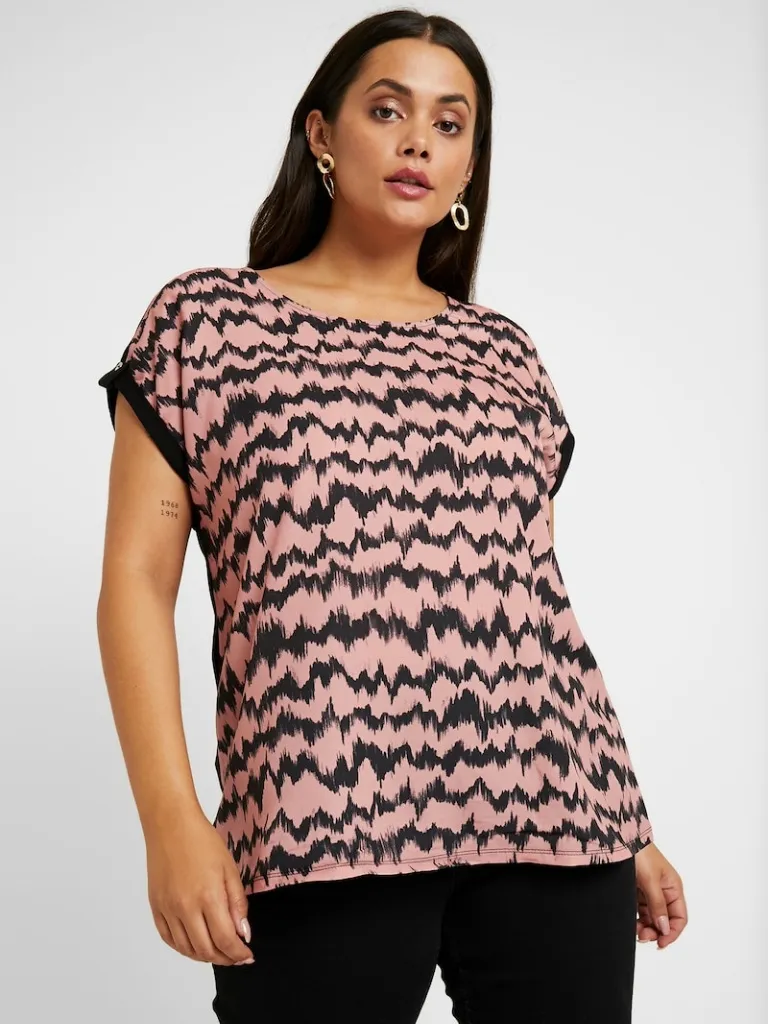
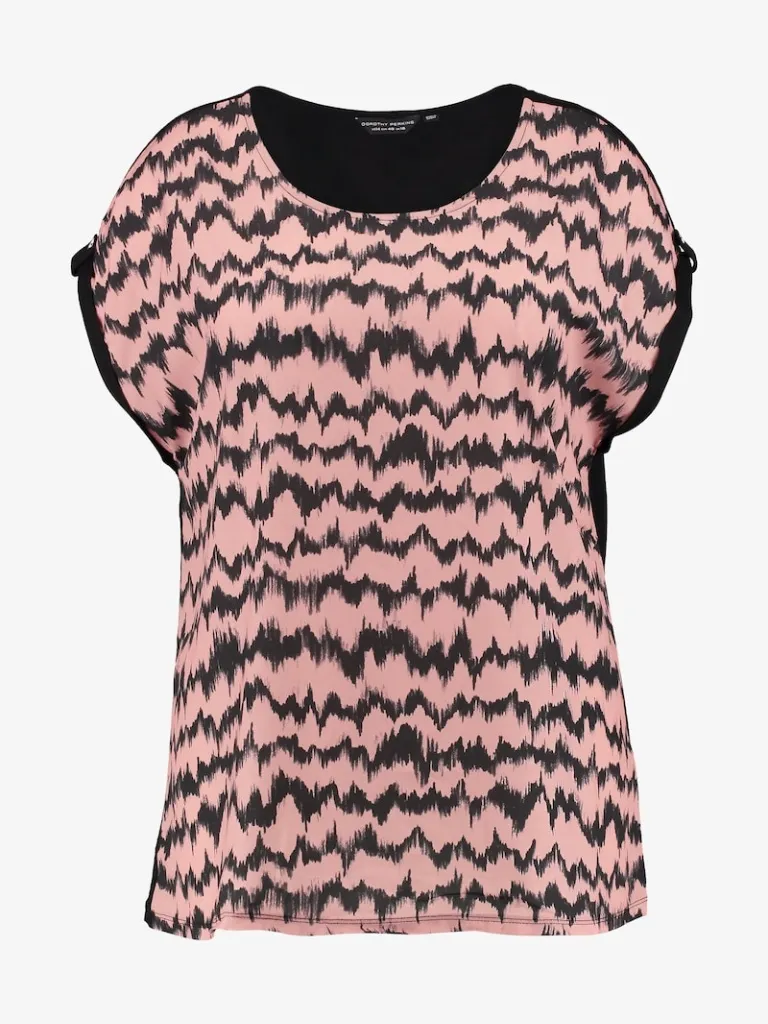
입은 상의 사진을 흰 배경의 정면 제품 사진으로 바꾸는 MiniMax H3 Image용 트라이오프 LoRA입니다. 비상업 연구용 데이터인 VITON-HD 500쌍으로 1,500스텝 학습했고, 학습에 쓰지 않은 상용 브랜드 사진 10장으로 테스트했습니다. 테스트에는 학습 데이터에 거의 없는 패딩, 후드, 카디건도 포함했습니다.
무엇을 만들었나
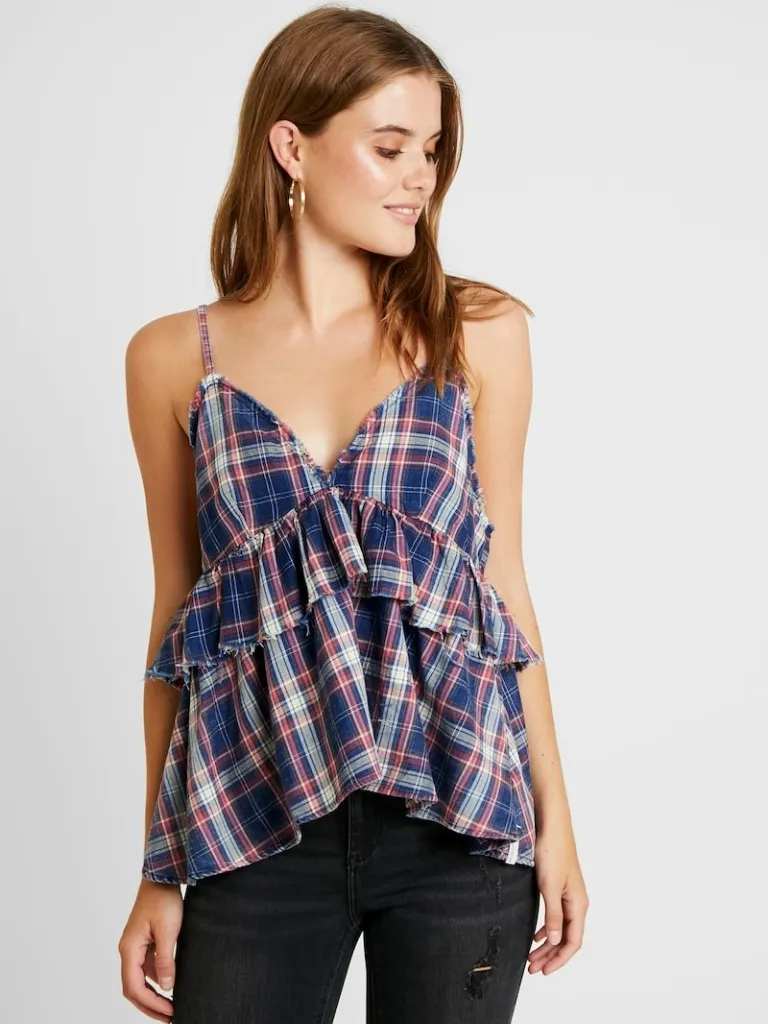
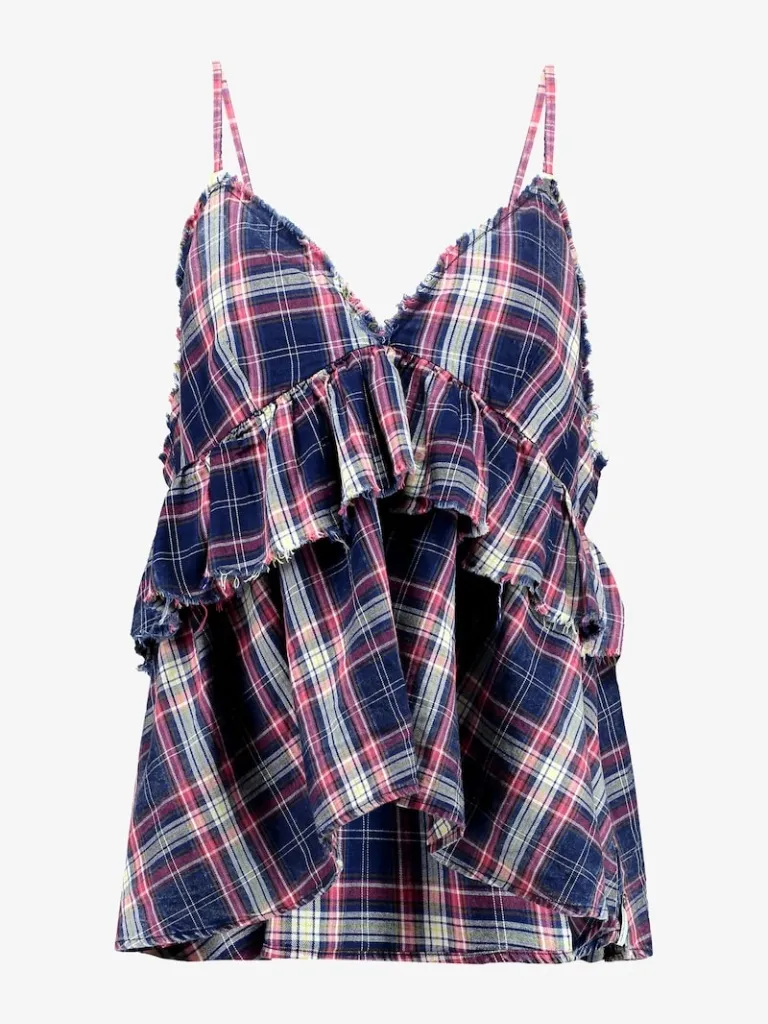
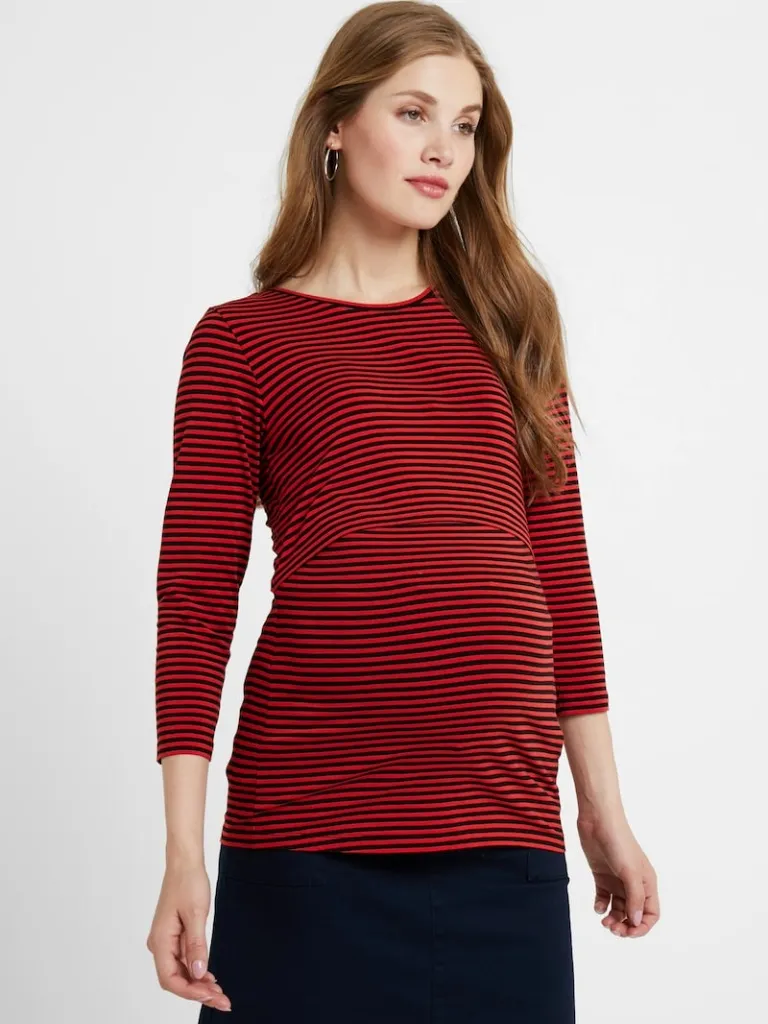
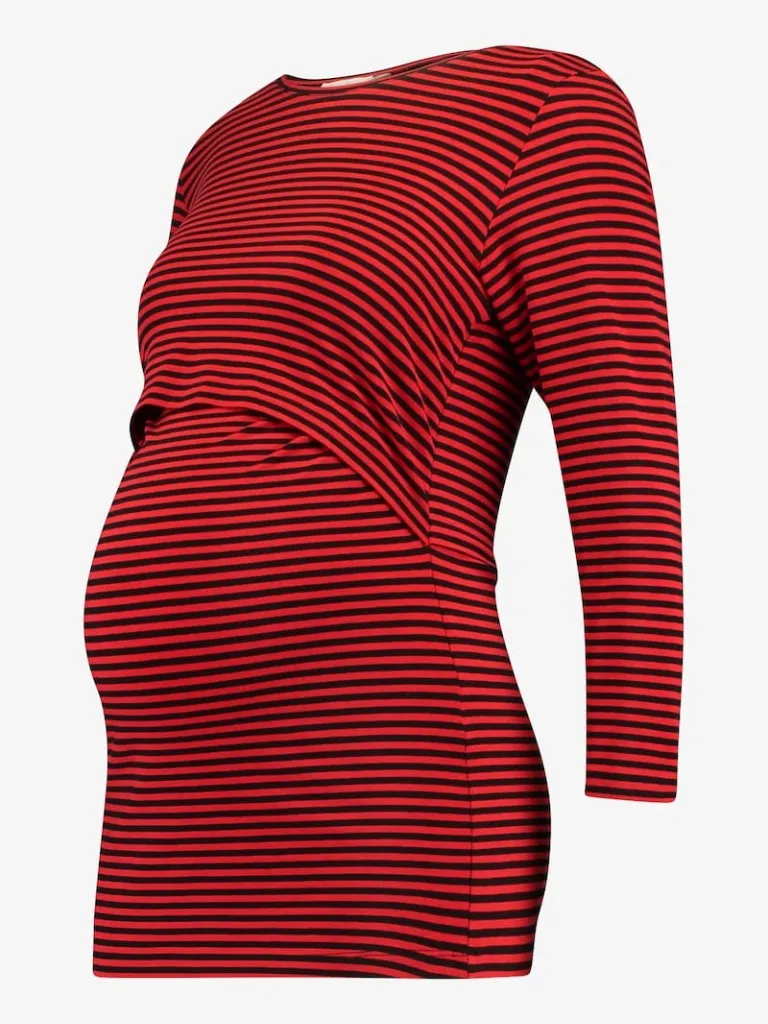
사람이 입고 있는 상의 사진을 넣으면, 같은 옷을 흰 배경의 정면 제품 사진으로 바꿔 주는 트라이오프(try-off) LoRA입니다. 착장 사진만 있고 제품 사진이 없는 상황에서 상품 이미지를 만드는 용도를 생각하고 학습했습니다.
학습
- 데이터: VITON-HD 공식 데이터의 학습 세트(11,647쌍)에서 착장 사진과 파일 이름이 같은 상의 단독 사진을 한 쌍으로 묶고, 그중 500쌍을 골랐습니다. 옷 종류와 색, 무늬가 고르게 섞이도록 GPT로 일괄 분류해서 골랐고, 사람이 한 쌍씩 확인하지는 않았습니다.
- 옷 종류 분포(자동 분류 기준): 티셔츠 170, 블라우스 115, 니트 75, 탱크톱 70, 스웨트셔츠 28, 셔츠 19, 기타 20, 후드 2, 아우터 1쌍입니다.
- 설정: AI-Toolkit으로 MiniMax H3 Image를 학습했습니다. 트랜스포머는 INT8, Qwen3-VL 텍스트 인코더는 NVFP4로 양자화했습니다. LoRA rank 16(alpha 16), 1,500스텝, 배치 1, 학습률 1e-4, AdamW 8bit, 해상도는 1024 버킷(VITON-HD 원본 768×1024)입니다.
- 학습 시간: 중간 샘플 생성을 끄고 학습해서 1,500스텝에 3시간 19분이 걸렸습니다.
테스트
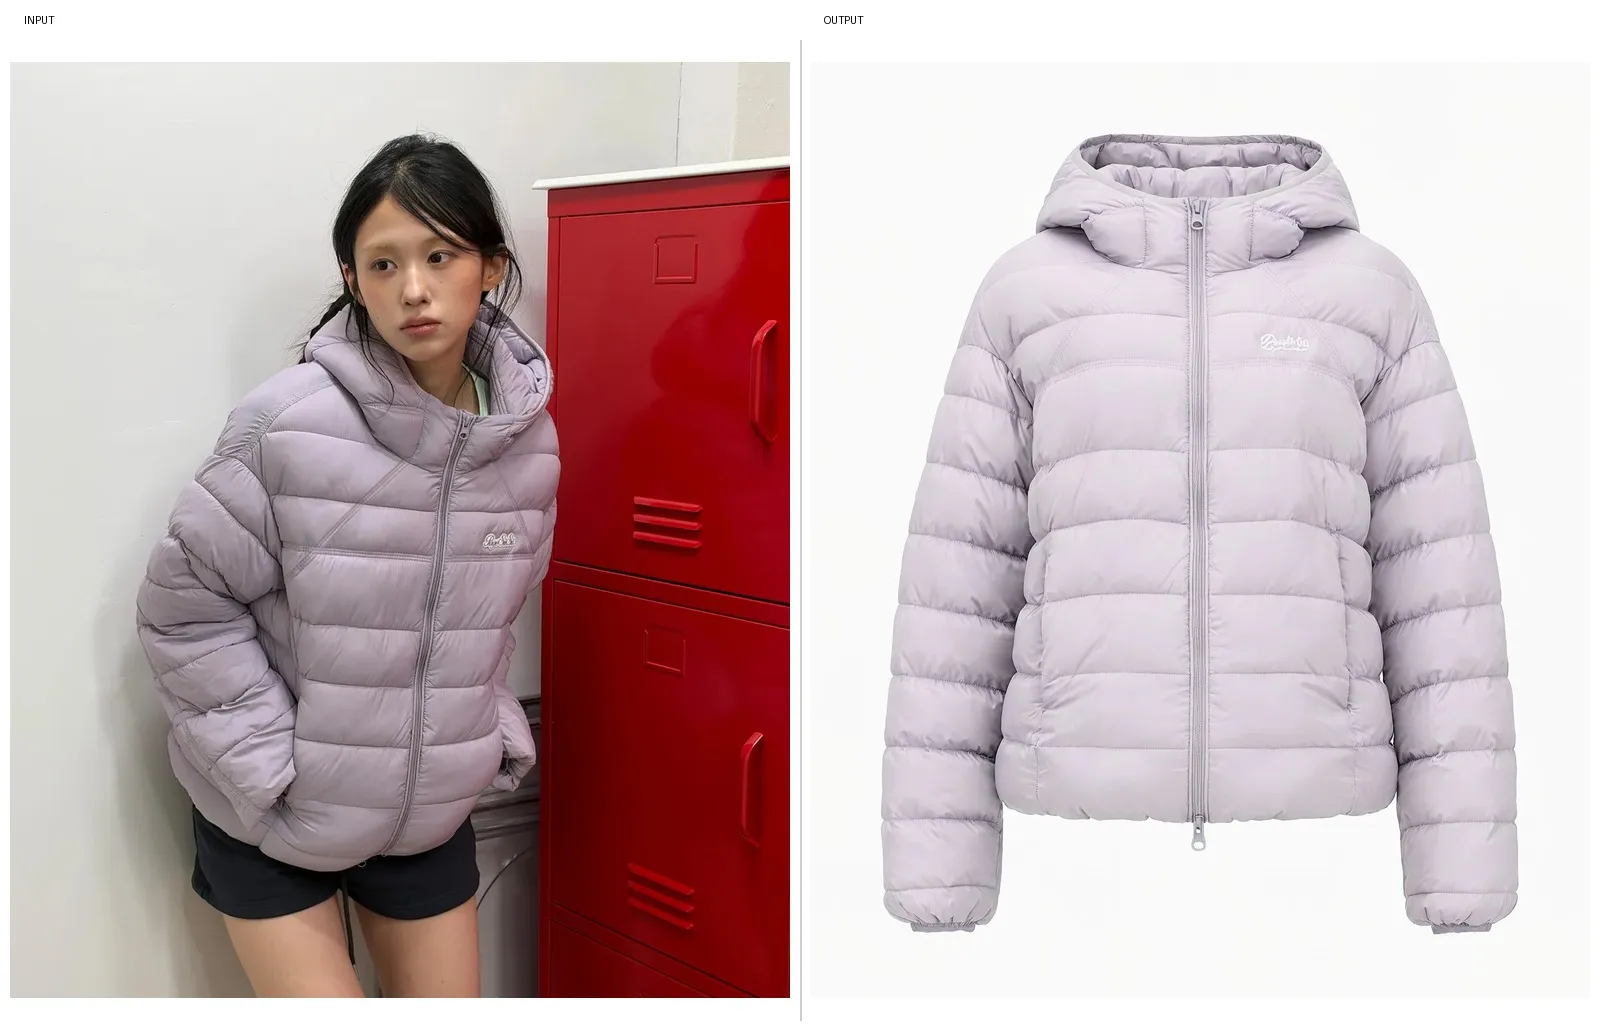
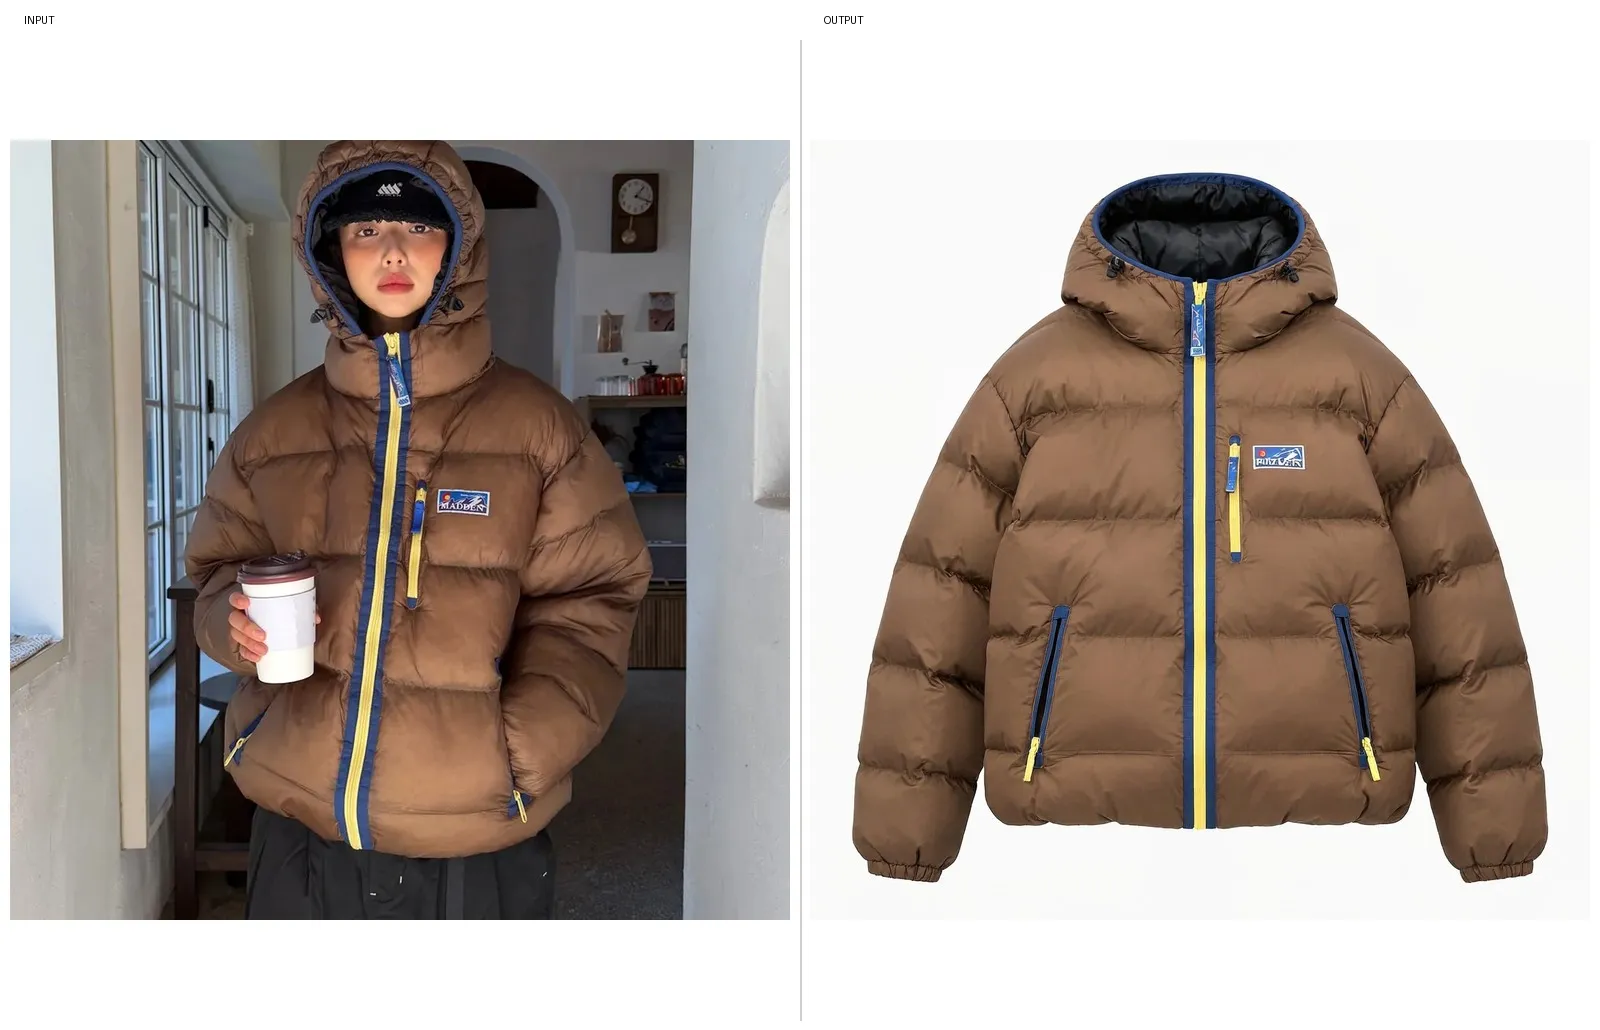
학습에 쓰지 않은 상용 브랜드의 착장 사진 10장으로 결과를 확인했습니다. 약 2MP(1280×1536 등) 해상도, 6스텝, seed 42, LoRA 강도 1로 생성했습니다.
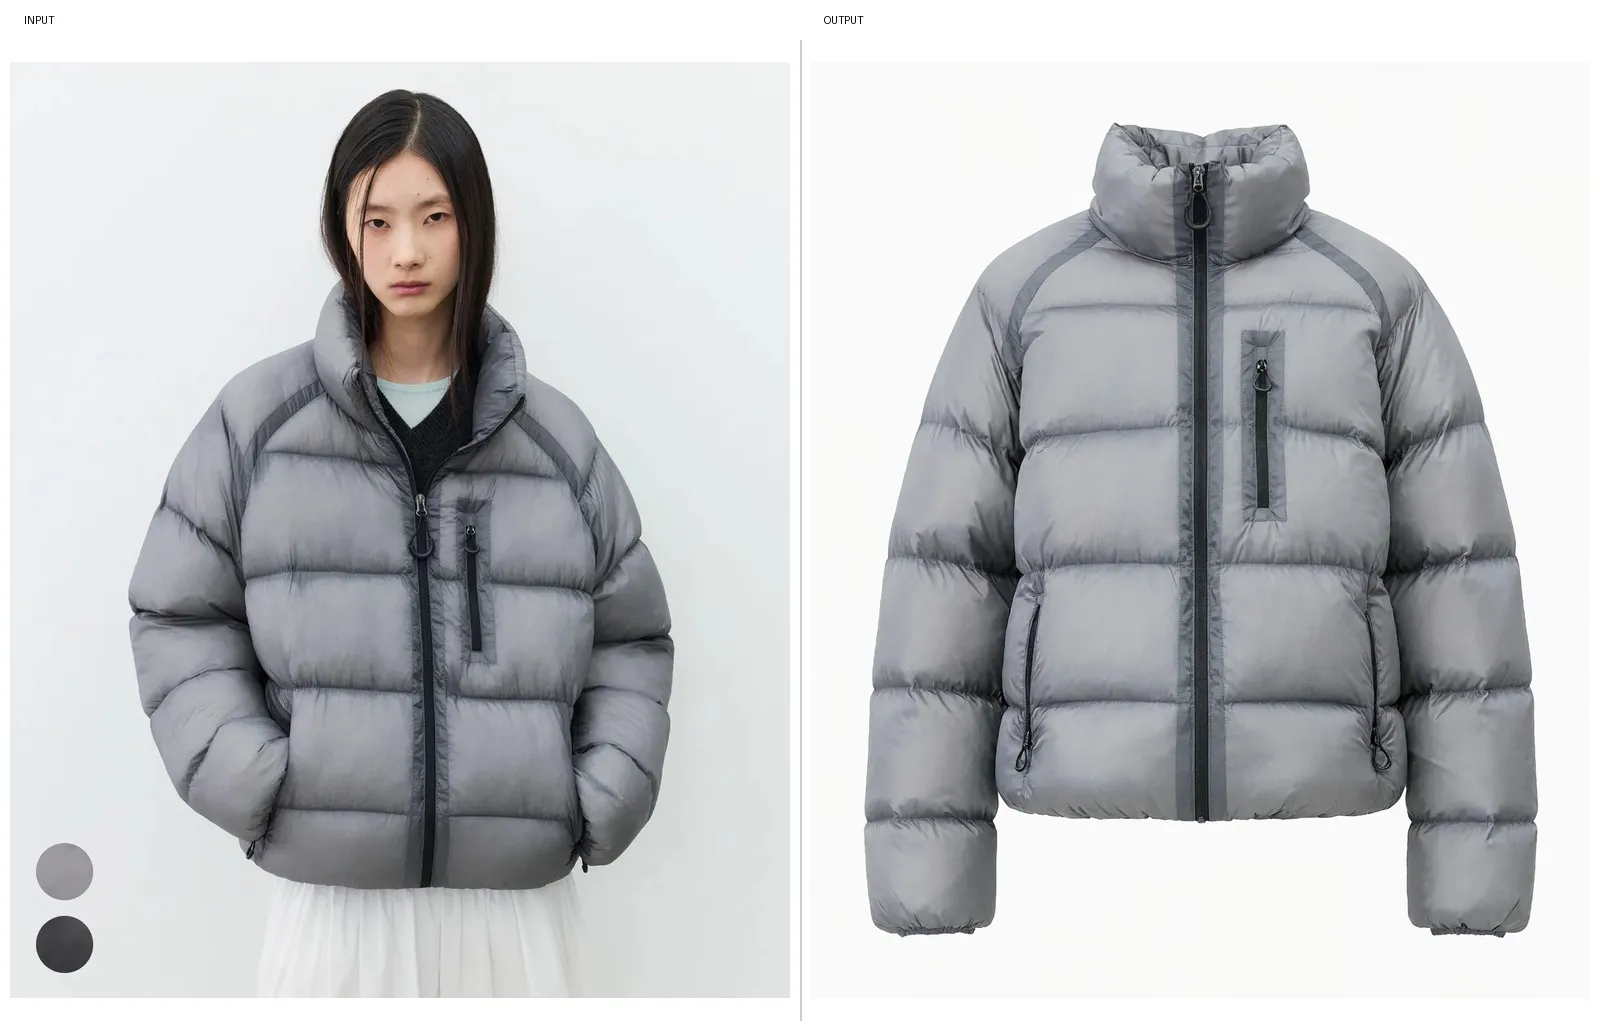
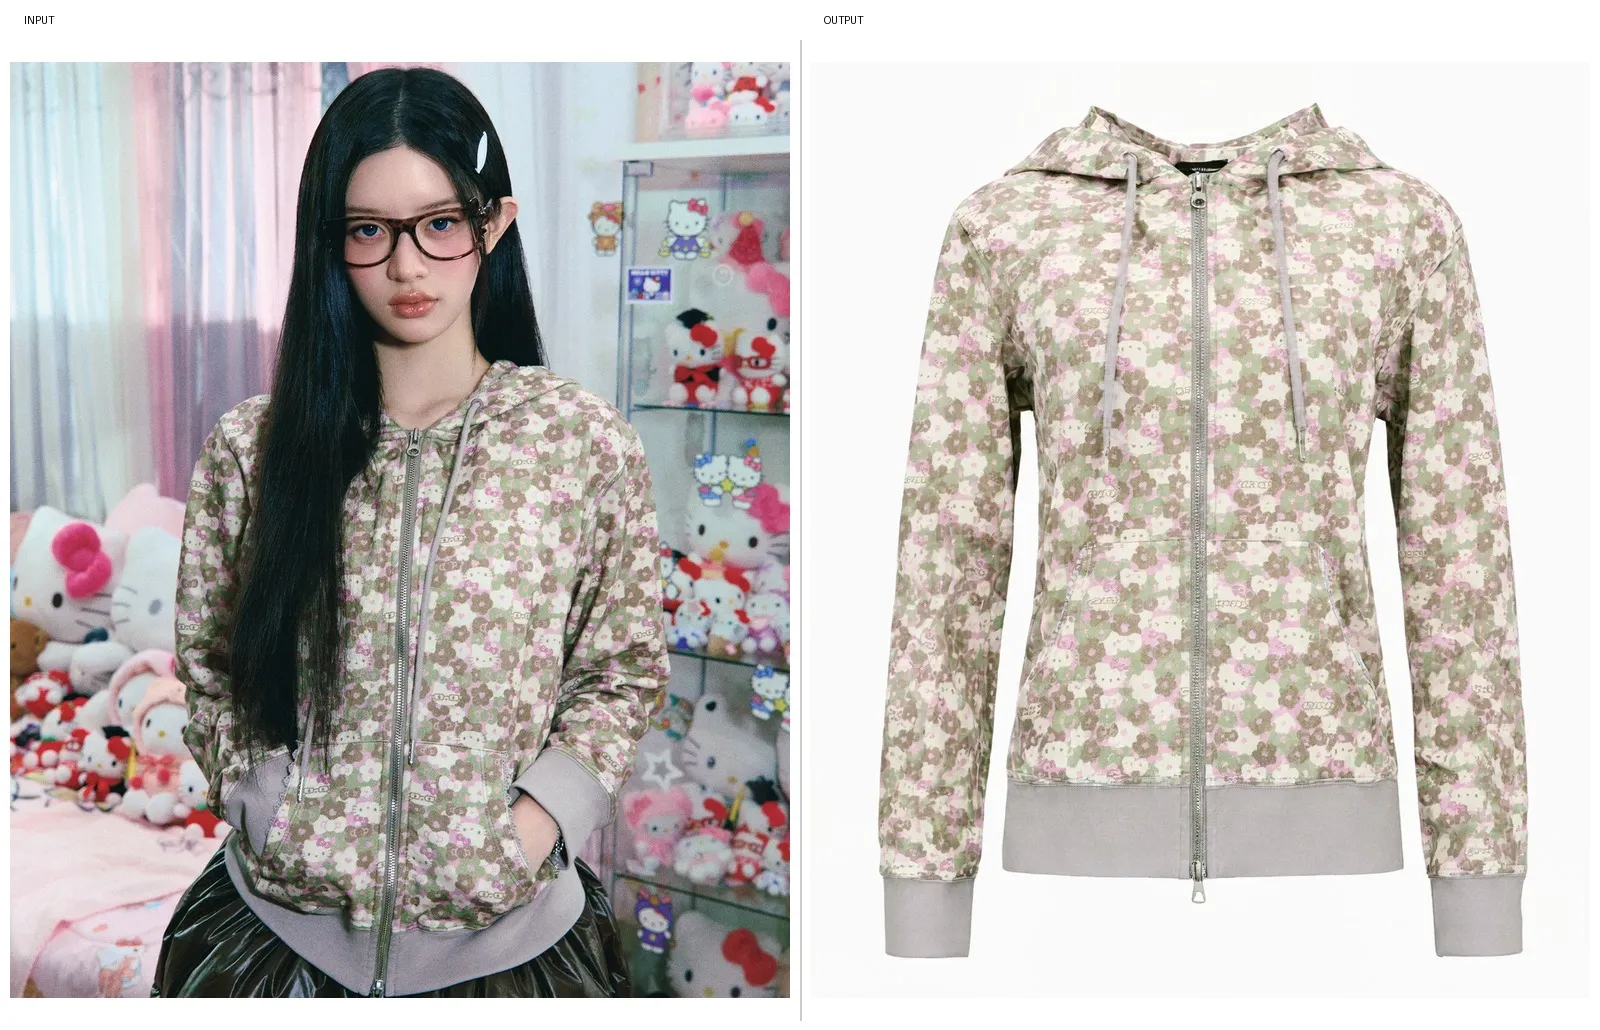
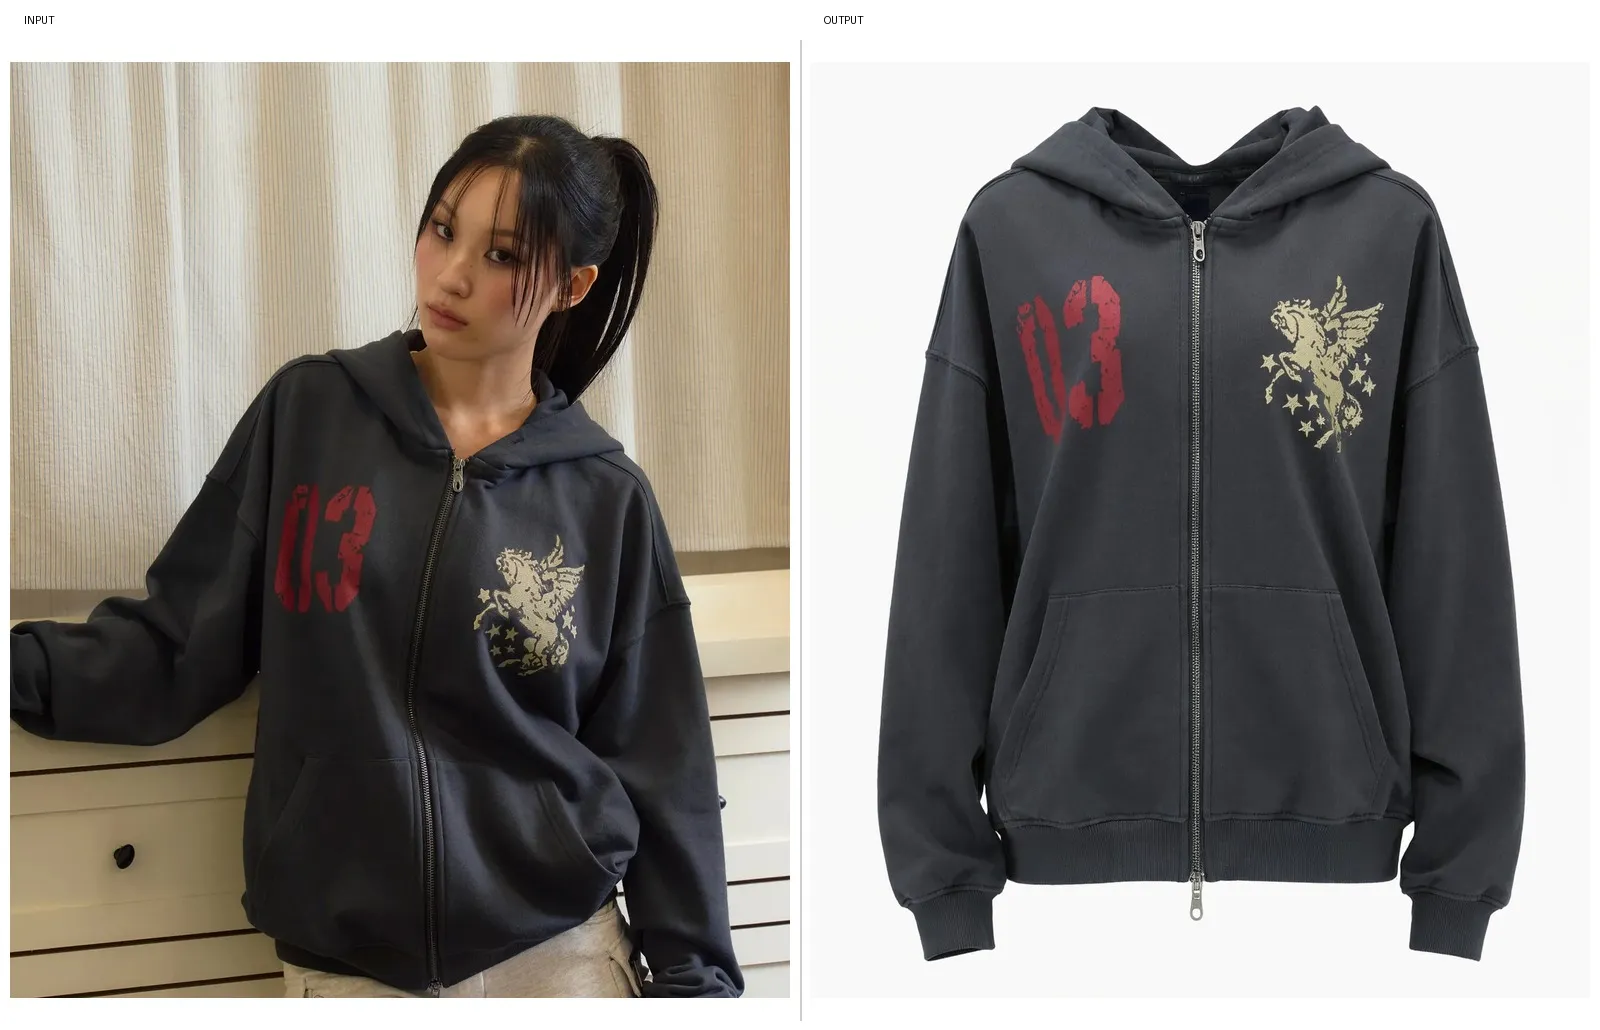
- 안 배운 옷 종류에도 동작합니다. 학습 데이터에는 아우터가 1쌍, 후드가 2쌍뿐인데, 테스트 10장에는 패딩 3장과 후드 집업 3장이 들어 있습니다. 나머지는 니트 카디건 2장, 프린지 니트 탑, 레이스 코르셋 탑입니다. 색, 퀼팅, 지퍼, 단추, 리본, 레이스, 전체 무늬가 대부분 유지되었습니다.
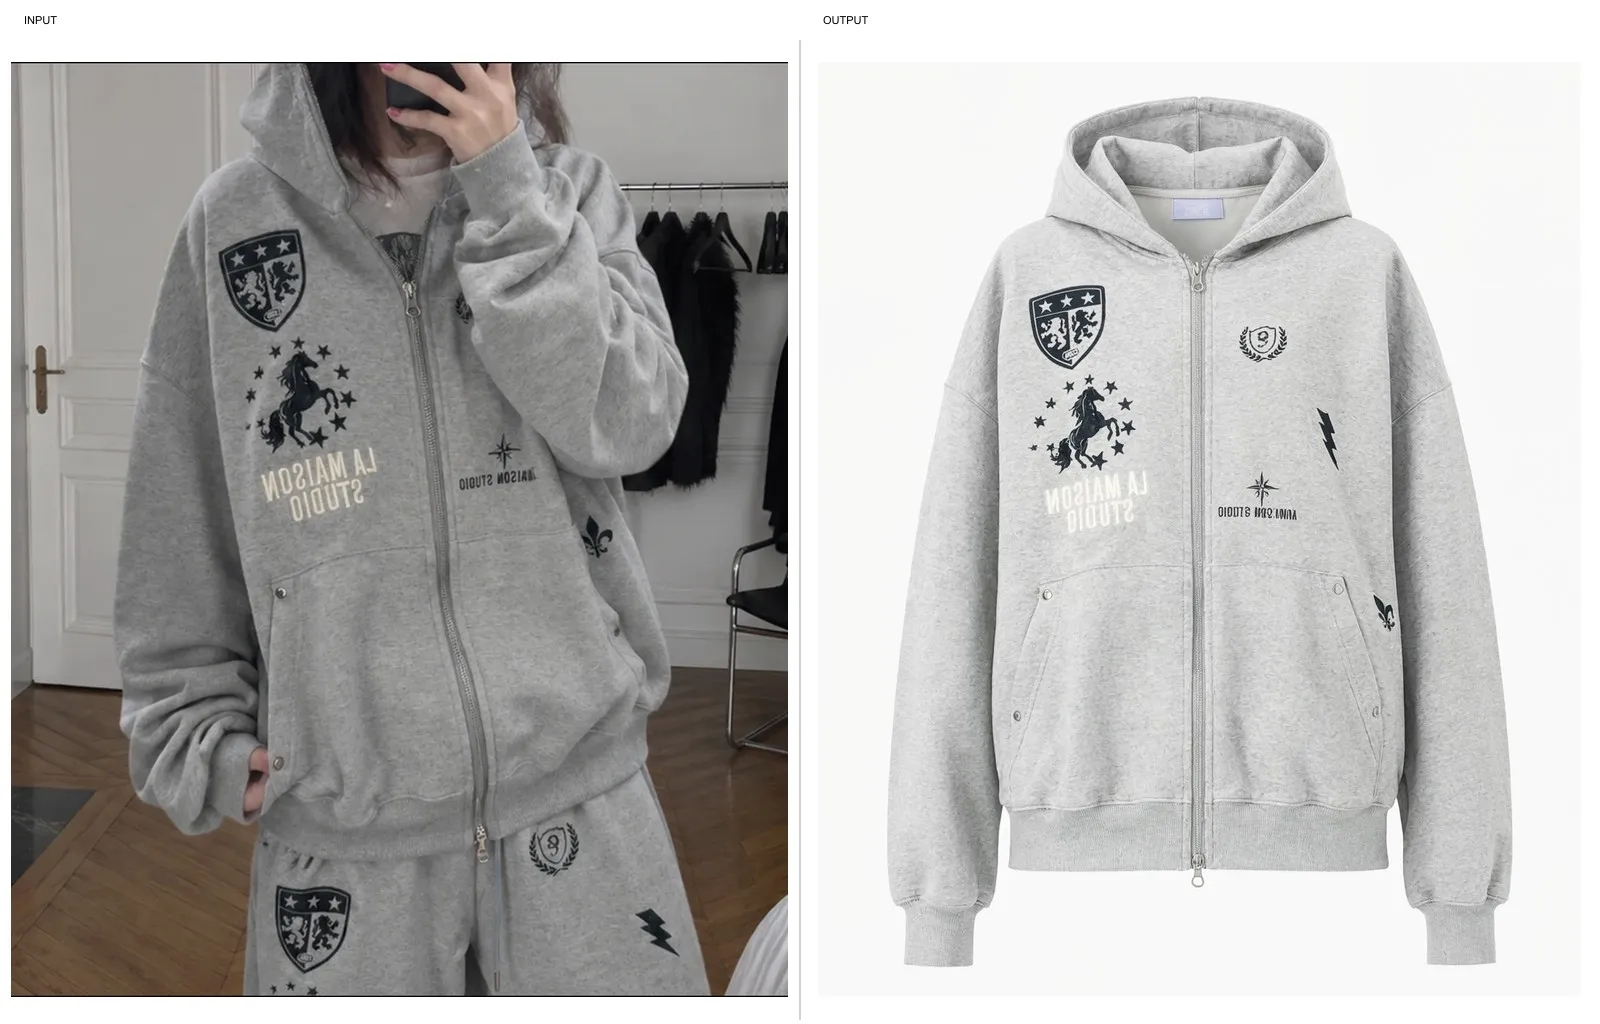
- 한계는 로고와 글자입니다. 패치의 브랜드 이름이 뭉개지거나(2번째), 좌우가 뒤집힌 자수 글자가 다른 글자로 바뀌었습니다(6번째). 원본에 없는 작은 안쪽 라벨이 생기기도 합니다. 상의만 꺼내라고 지시했는데, 상하의가 한 벌인 코르셋 탑(9번째)은 스커트까지 함께 꺼냈습니다.
- 수치 지표로 채점하지는 않았고, 입력과 결과를 나란히 놓고 눈으로 비교했습니다.
데이터와 이미지 고지
- 학습 데이터: VITON-HD(Choi et al., CVPR 2021)를 사용했습니다. 이 데이터는 CC BY-NC 4.0 조건의 비상업 연구용 데이터이므로, 이 LoRA와 학습 데이터는 비상업 목적으로만 쓰고 배포하지 않습니다. 아래 학습 데이터 예시 3쌍은 VITON-HD 원본 그대로입니다.
- 추론 테스트 이미지: 상용 브랜드의 공개 착장 사진이며, 모델 테스트에만 사용했고 학습에는 전혀 사용하지 않았습니다. 학습에 쓴 이미지 1,000장(착장 500장, 제품 500장)과 이미지 해시로 대조해 겹치는 사진이 없음을 확인했습니다. 사진과 상품의 권리는 각 브랜드와 촬영자에게 있으며, 권리자가 요청하면 즉시 내리겠습니다.
이미지 (16)
추론 테스트 · 상용 브랜드 착장 사진 → 생성한 제품 사진 (학습에 쓰지 않은 사진)
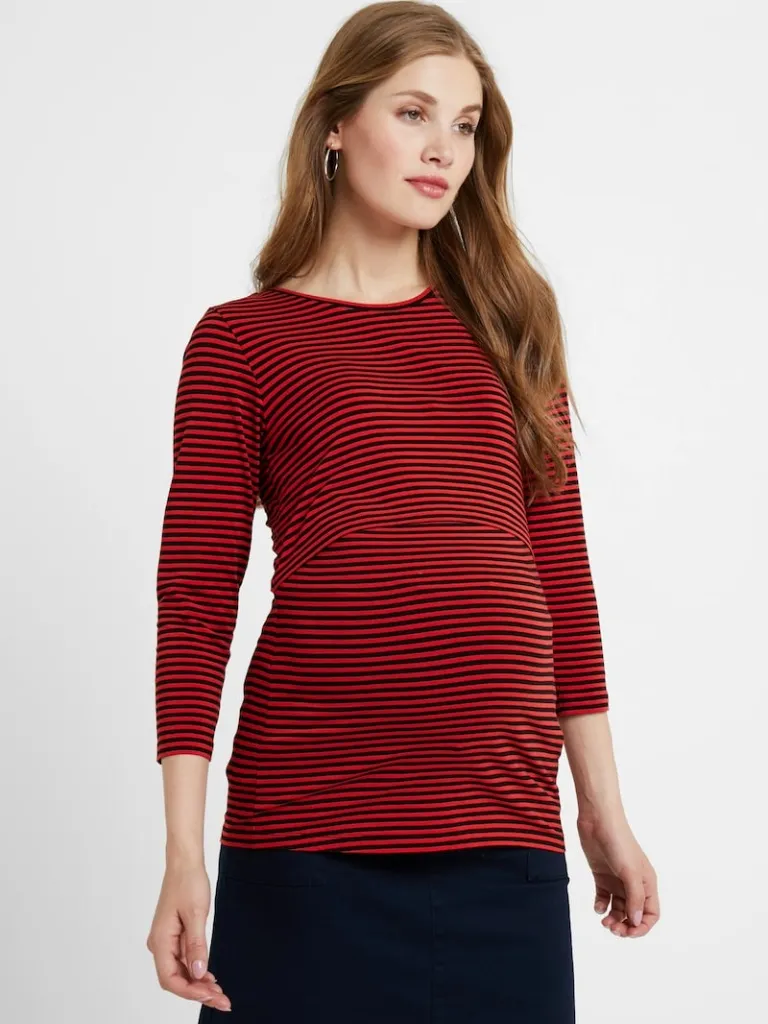
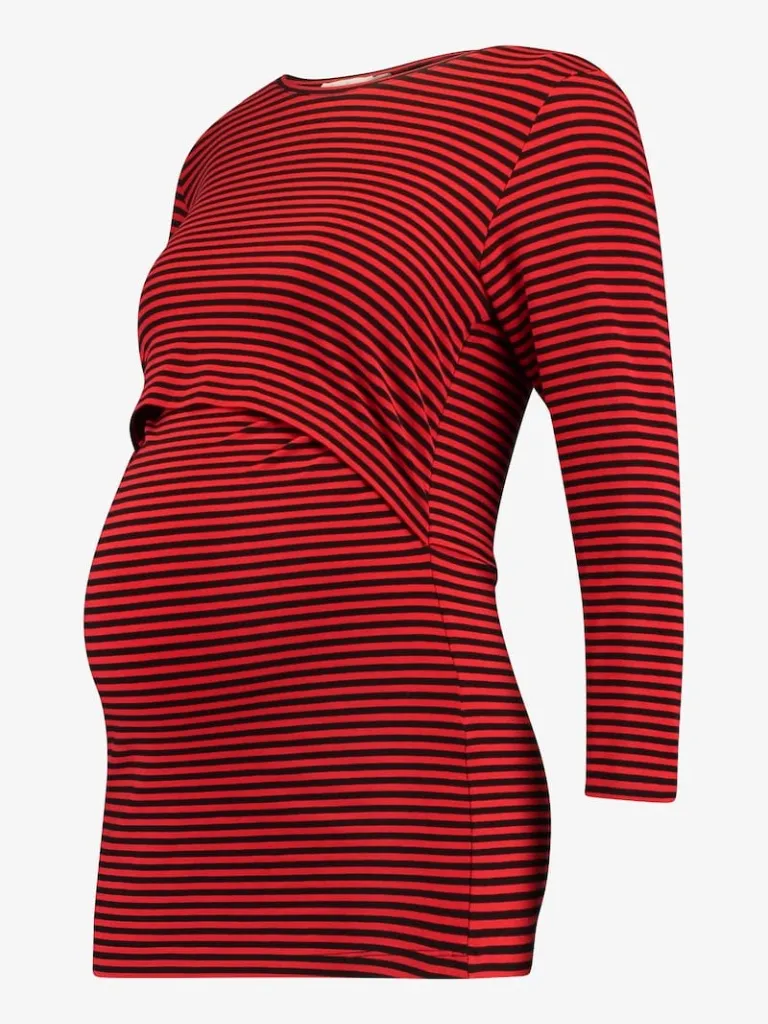
학습 데이터 예시 · VITON-HD 착장 → 제품 (500쌍 중 3쌍, CC BY-NC 4.0)